目次
シーケンスデータは、どれくらい必要?
NGSの解析手法が決まると、次に考えるのが「1検体あたり、どれくらいのデータを取得するか」です。
全ゲノム解析では、ゲノムサイズと必要な読み取りの深さが目安になります。一方、RNA-seqでは遺伝子ごとの発現量が異なるため、ゲノムサイズだけでは必要量を決められません。
どちらも、データを増やせば少ない情報を捉えやすくなりますが、費用や解析負荷も増えます。本記事では、全ゲノム解析とRNA-seqを例に、目的に合ったデータ量の考え方を紹介します。
データ量を表す「リード数」と「塩基数」
NGSのサービス仕様や見積書では、主に次の単位が使われます。
| 指標 | 意味 | 表記例 |
| リード数 | 読み取った配列の本数 | 2,000万リード |
| 塩基数 | 読み取った配列の長さの合計 | 6 Gb |
1本のリードが150塩基なら、2,000万リードは合計30億塩基、つまり3 Gbに相当します。
DNA断片の両端を読む「ペアエンド」では、1つの断片から2本のリードが得られます。150塩基×2方向で2,000万リードペアを取得すると、合計は6 Gbです。
「2,000万リード」と「2,000万リードペア」は異なります。 仕様を比較する際は、リード長と本数の数え方を確認しましょう。
全ゲノム解析:ゲノムサイズとカバレッジから考える
カバレッジとは?
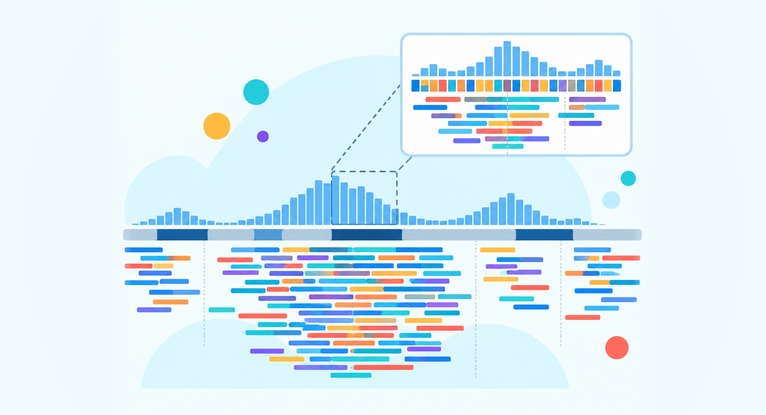
全ゲノム解析では、ゲノムの各位置を平均して何回読んだかを表す「カバレッジ」が、データ量を決める目安になります。「30×」は平均30回読んだことに相当し、平均深度とも呼ばれます。
平均カバレッジ(×)=取得した塩基数÷ゲノムサイズ
例えば、ゲノムサイズが5 Mbの細菌から500 Mbのデータを取得すると、理論上の平均カバレッジは100×です。通常は、参照ゲノムの長さ、一般には一倍体相当のゲノムサイズを基準に計算します。
逆に、目標カバレッジが決まっていれば、必要な塩基数を求められます。
必要な塩基数=ゲノムサイズ×目標カバレッジ
| ゲノムサイズの例 | 目標カバレッジ | 理論上必要な塩基数 |
| 5 Mb | 100x | 500 Mb=0.5 Gb |
| 100 Mb | 30x | 3 Gb |
| 3 Gb | 30x | 90 Gb |
※数値は計算例であり、各生物の推奨データ量ではありません。QCなどによるデータの減少も含めていません。
平均深度だけでは判断できない
平均30×でも、すべての位置を30回読めるわけではありません。 GC含量や反復配列、ライブラリ調製、マッピングのしやすさなどによって、読み取りには偏りが生じます。
また、必要な深度は解析目的でも変わります。ヒトWGSの評価研究では、SNVとInDelで、深度による検出精度の変化が異なりました。[1] 低頻度変異を探す場合には、その変異を支持するリードを十分に得るため、より高い深度が必要になります。
ゲノムを新たに組み立てる場合も、完成度やゲノムの特徴を考慮します。反復配列が原因でつながらない場合は、ショートリードを増やすだけでなく、ロングリードの利用を検討します。
つまり、ゲノムサイズからデータ量を計算する前に、どのような変異を調べたいか、どこまでゲノムを再構築したいかを決めることが大切です。
RNA-seq:どの程度少ないRNAまで捉えたいか
遺伝子によって得られるリード数が異なる
RNA-seqでは、発現量の多いRNAには多くのリードが、少ないRNAにはわずかなリードしか得られません。そのため、全ゲノム解析のようにゲノム全体の「30×」を基準として設計するのではなく、検体あたりのリード数や塩基数で考えます。
必要なデータ量は、知りたい内容によって変わります。
| 解析の目的 | データ量を考える際のポイント |
|---|---|
| 遺伝子ごとの発現量を比較する | 対象遺伝子の発現量と、条件間で検出したい差を確認する |
| 低発現の遺伝子を調べる | 少ないRNAにも十分なリードが得られるようにする |
| 同じ遺伝子から生じる転写産物を区別する | データ量に加え、リード長や解析手法も検討する |
データ量を増やすと、低発現の遺伝子を捉えやすくなります。ただし、すでに十分なリードが得られている遺伝子では、追加シーケンスによる改善が小さくなることもあります。
ライブラリ調製法によっても変わる
RNA-seqでは、どのRNAを読み取るかも重要です。
真核生物のmRNAを中心に調べるpoly(A)濃縮法と、poly(A)を持たないRNAも対象に含められるrRNA除去法では、得られる配列の構成が異なります。[2] 同じ6 Gbを取得しても、目的とする遺伝子の評価に使えるリード数が同じとは限りません。
そのため、対象生物だけでなく、ライブラリ調製法と解析目的をそろえて必要量を検討します。
取得したデータ量と、解析に使えるデータ量は違う
取得した配列のすべてが、そのまま解析に使えるわけではありません。低品質配列やアダプターの除去、マッピングなどを経ることで、利用できるデータ量は減少します。
RNA-seqでは、残存するrRNAなどにリードが割かれることもあります。見積もりやサービス仕様を確認する際は、提示された数値が「取得直後のデータ量」なのか、「QC後のデータ量」なのかを確認しましょう。
過去の同種試料の結果や予備解析があれば、必要量を見積もる参考になります。
データ量とサンプル数を一緒に考える
比較研究では、1検体を深く読むだけでなく、独立した検体数を確保することも重要です。
特にRNA-seqでは、生物学的反復数が発現差の検出に影響します。[3] 1検体のシーケンス量を増やしても、個体差や培養ごとのばらつきを評価するための反復の代わりにはなりません。
発注前には、次の3点を整理すると相談が進めやすくなります。
- 目的: どのような変異や発現の違いを調べたいか。
- 試料: 対象生物、DNA・RNAの品質、比較する群と検体数はどうか。
- 仕様: リード長、リード数の数え方、QC前後のどのデータ量を指すか。
bitBiomeでは、必要なデータ量が決まっていない段階からご相談いただけます。対象生物や試料、調べたい内容をお聞かせください。
参考文献
- [1] Kishikawa T, et al. Empirical evaluation of variant calling accuracy using ultra-deep whole-genome sequencing data. Scientific Reports. 2019;9:1784.
- [2] Zhao S, et al. Evaluation of two main RNA-seq approaches for gene quantification in clinical RNA sequencing: polyA+ selection versus rRNA depletion. Scientific Reports. 2018;8:4781.
- [3] Schurch NJ, et al. How many biological replicates are needed in an RNA-seq experiment and which differential expression tool should you use? RNA. 2016;22:839–851.